מדריך Bright Data בעברית: איסוף מידע מהרשת וגישה חיה לקלוד (2026)
קורס חינמי לבעלי עסקים ולמפתחים: מעקב מחירים של מתחרים, נתונים מאינסטגרם ומפייסבוק, רשימות לידים, וחיבור קלוד לרשת דרך שרת ה-MCP. עם פלט אמיתי, מחירים שנבדקו באוקטובר 2026, ופרק על החוקיות.
Bright Data (ברייט דאטה) היא חברה ישראלית שאוספת בשבילכם מידע ציבורי מאתרים: מחירי מתחרים, פוסטים מאינסטגרם ומפייסבוק, ותוצאות חיפוש. יש יותר מ-1,000 סקרייפרים מוכנים, 5,000 קרדיטים חינם בחודש בלי כרטיס, ואחר כך 1.5$ לכל 1,000 רשומות. דרך שרת ה-MCP שלה קלוד מקבל גישה חיה לרשת.
מאת הנרי שטאובר · מומחה AI ומרצה · עודכן: 2026-10-12 · פורסם: 2026-10-12
מבוא: מה זה Bright Data ולמה עסק קטן צריך את זה
בסוף הפרק תוכלו להסביר במשפט אחד מה Bright Data עושה, ותדעו אם הקורס הזה בשבילכם.
כ-12 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
Bright Data (ברייט דאטה) היא חברה ישראלית שאוספת מידע ציבורי מאתרים בשבילכם. אתם אומרים מה אתם צריכים, למשל מחירים של מתחרים או פוסטים מדף פייסבוק, ומקבלים טבלה מסודרת.
היא גם נותנת לקלוד ולסוכני AI אחרים גישה חיה לרשת, כך שהם עונים לפי מה שכתוב באתר היום ולא לפי מה שהם זוכרים.
Bright Data בארבעה משפטים
- אתם מבקשים מידע ציבורי מהרשת: דף, תוצאות חיפוש, פוסטים או מוצרים.
- Bright Data מטפלת בחסימות, בקפצ'ות ובטעינה של האתר.
- אתם מקבלים טבלה או טקסט נקי, מוכנים לאקסל או לקלוד.
- משלמים לפי שימוש, ויש 5,000 קרדיטים חינם בכל חודש.
למי הקורס מתאים
לבעלי עסקים שרוצים לעקוב אחרי מתחרים, לאסוף לידים או לנטר רשתות חברתיות בלי לכתוב קוד.
ולמפתחים: פרק נפרד מראה את ה-API ואת הקוד שהנרי מריץ בעצמו.
גילוי נאות
הקישורים ל-Bright Data בדף הזה הם קישורי שותפים. אם תפתחו חשבון ותשלמו, הנרי מקבל אחוז מהתשלום. המחיר שלכם לא משתנה.
כל העובדות בדף נבדקו מול האתר הרשמי ב-12 באוקטובר 2026.
סרטון ההדרכה המלא - בקרוב
כאן יופיע סרטון ההדרכה המלא על Bright Data מהערוץ @AIWithHenry. עד שיעלה, הקורס מלמד הכל בטקסט ובצילומים.
בינתיים יש סרטונים על MCP בפרק ״לתת לקלוד גישה לרשת״.
תרגיל: שאלה אחת שהייתם רוצים לשאול את הרשת
- כתבו שאלה עסקית אחת שהתשובה עליה נמצאת באתרים של אחרים.
- לדוגמה: ״כמה עולה המוצר שלי אצל שלושה מתחרים?״
- רשמו מאיפה הייתם אוספים את התשובה היום, וכמה זמן זה לוקח.
איך יודעים שהצליח: יש לכם שאלה אחת, רשימת אתרים ואומדן זמן. נחזור אליה בפרק התרגול.
מה ההבדל בין לשאול את קלוד שאלה רגילה לבין לשאול אותו עם Bright Data מחובר?
בלי חיבור קלוד עונה מהזיכרון או מחיפוש בסיסי. עם Bright Data הוא קורא את הדף עצמו ברגע השאלה, גם כשהאתר חוסם רובוטים, ומחזיר נתונים מסודרים.
מושגי יסוד: גירוד, חסימות, רשומות וקרדיטים
בסוף הפרק תבינו את חמשת המושגים שחוזרים בכל הקורס, ותדעו לחשב כמה קרדיטים משימה צורכת.
כ-10 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
לפני שבוחרים מוצר צריך לדבר באותה שפה. חמישה מושגים, כל אחד במשפט.
חמשת המושגים
- גירוד (Scraping) - תוכנה שקוראת דף אינטרנט ציבורי והופכת אותו לנתונים.
- חסימה - אתרים מזהים רובוטים ועוצרים אותם בקפצ'ה או בחסימת כתובת.
- בקשה - פנייה אחת לדף אחד או לחיפוש אחד.
- רשומה - שורה אחת בטבלה שחוזרת: פוסט אחד, מוצר אחד, עסק אחד.
- קרדיט - יחידת התשלום: קרדיט אחד לבקשה או לרשומה.
איך מחשבים עלות
בקשה אחת או רשומה אחת עולות קרדיט אחד. 5,000 קרדיטים החינמיים בחודש שווים בערך 7.5$.
אחרי זה המחיר הוא 1.5$ לכל 1,000. כלומר 100 מוצרים של מתחרים ביום, במשך חודש, הם כ-3,000 רשומות, עדיין בתוך החינם.
טכניקה מתקדמת: בקשו פחות רשומות
רוב הסקרייפרים מקבלים שדה של כמות, כמו num_of_posts, וגם טווח תאריכים.
הנרי אוסף כל יום רק פוסטים שפורסמו מאז הריצה הקודמת, ועד 20 למקור. ככה החשבון לא מתנפח.
ציבורי בלבד
כל מה שבקורס עוסק במידע שכל אחד יכול לראות בלי להתחבר. מידע מאחורי סיסמה, וקבוצות פרטיות, הם סיפור אחר. פרק החוקיות מסביר למה.
המוצרים של Bright Data: מה לבחור לכל משימה
בסוף הפרק תדעו איזה מוצר של Bright Data מתאים למשימה שלכם, ומה החלופות.
כ-12 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
באתר של Bright Data יש יותר מעשרה מוצרים, וזה מבלבל. בפועל בעל עסק צריך שלושה או ארבעה מהם.
בסוף הפרק יש גם שלושה כלים מתחרים, כי לפעמים הם מתאימים יותר.
שבעה מוצרים, משפט לכל אחד
- Web Scraper API (סקרייפרים מוכנים) - יותר מ-1,000 סקרייפרים לאתרים מוכרים: אינסטגרם, פייסבוק, אמזון, גוגל מפות.
- Unlocker API - שולפים כל דף ציבורי, והחסימות עליהם.
- SERP API - תוצאות חיפוש מגוגל, בינג ועוד חמישה מנועים, ב-195 מדינות.
- AI Scraper Studio - מתארים במילים אתר שאין לו סקרייפר, ומקבלים סקרייפר.
- Browser API - דפדפן בענן שיודע ללחוץ, לגלול ולמלא טפסים.
- Datasets - מאגרי נתונים מוכנים לקנייה.
- שרת MCP - מחבר את כל זה לקלוד ולסוכני AI.
איך בוחרים
- יש סקרייפר מוכן לאתר? מתחילים ב-Web Scraper API.
- אין, וצריך דף אחד או כמה? Unlocker API.
- צריך לדעת מה גוגל מראה על מילת חיפוש? SERP API.
- צריך לעבוד מתוך צ'אט עם AI? שרת ה-MCP, שמשתמש באותם מוצרים מאחורי הקלעים.
Bright Data
החוזקה שלה היא ספרייה של יותר מ-1,000 סקרייפרים מוכנים לאתרים כמו אינסטגרם, פייסבוק ואמזון, עם טיפול בחסימות בפנים. מקבלים טבלה מסודרת ומשלמים רק על רשומה שהצליחה.
Apify
חנות עם עשרות אלפי כלי איסוף (Actors) שבנו מפתחים מכל העולם. מתאים כשצריך אתר נישתי שאין לו סקרייפר אצל אחרים. 5$ שימוש בחודש בחינם.
Firecrawl
בנוי בשביל מפתחים וסוכני AI: הופך אתר שלם לטקסט נקי, ויש לו endpoint שמקבל רק פרומפט. קוד פתוח, ו-1,000 קרדיטים חינם בכל חודש.
ScrapeGraph-AI
חילוץ נתונים מדף לפי תיאור במילים, בלי לכתוב סלקטורים. הספרייה חינמית וקוד פתוח למי שמתכנת בפייתון, ויש גם API מנוהל.
שמות שמשתנים
Bright Data משנה שמות מוצרים. Scraping Browser נקרא היום Browser API, ו-Web Unlocker מופיע גם כ-Unlocker API. אם מדריך ישן משתמש בשם אחר, זה כנראה אותו מוצר.
טבלת השוואה: Bright Data מול Apify, Firecrawl ו-ScrapeGraph-AI
בסוף הפרק תראו בטבלה אחת מה כל כלי נותן בחינם, כמה עולה הצעד הראשון בתשלום, ומה כל אחד יודע לעשות.
כ-6 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
הטבלה נבנתה מדפי המחירים והתיעוד הרשמיים של כל יצרן, שנקראו ב-12 באוקטובר 2026. מה שלא נמצא שם במפורש נכתב ״לא אומת״.
ארבעה כלים, שבע יכולות
| יכולת | Bright Data | Apify | Firecrawl | ScrapeGraph-AI |
|---|---|---|---|---|
| מסלול חינמי | 5,000 קרדיטים בחודש, בלי כרטיס | 5$ שימוש בחודש, בלי כרטיס | 1,000 קרדיטים בחודש, בלי כרטיס | 500 קרדיטים, חד-פעמי |
| הצעד הראשון בתשלום | לפי שימוש, 1.5$ ל-1,000 | Starter, 19$ לחודש | Hobby, 19$ לחודש | Starter, 20$ לחודש |
| שרת MCP רשמי | כן | כן | כן | כן |
| סקרייפרים מוכנים לרשתות חברתיות | כן, בספרייה שלה | כן, בחנות Actors | לא נמצא בתיעוד | לא נמצא |
| בניית סקרייפר מתיאור במילים | AI Scraper Studio | לא אומת | כן, Agent | כן, חילוץ לפי פרומפט |
| עקיפת חסימות מובנית | כן, כולל קפצ'ות | פרוקסי, רזידנציאלי בתשלום נוסף | כן | חלקית, במסלולים גבוהים |
| קוד פתוח | רק שרת ה-MCP | רק שרת ה-MCP | כן | כן, הספרייה |
מקורות: דפי המחירים והתיעוד של היצרנים, נבדקו ב-12 באוקטובר 2026, מחירים בדולר. ״לא אומת״ פירושו שלא נמצאה תשובה מפורשת בדף רשמי.
איך לקרוא את הטבלה
צריכים נתונים מרשתות חברתיות או מאתרי קניות גדולים? Bright Data ו-Apify. בונים סוכן שקורא אתרים כטקסט? Firecrawl. מתכנתים בפייתון ורוצים חינם? ScrapeGraph-AI.
מחירים זזים
בדקו את דף המחירים לפני שאתם משלמים. מבצעים, כמו הכפלת ההפקדה הראשונה ב-Bright Data, מופיעים ונעלמים.
פתיחת חשבון, 5,000 הקרדיטים החינמיים, וכמה זה עולה באמת
בסוף הפרק יהיה לכם חשבון פעיל, ותדעו להעריך כמה המשימה שלכם תעלה בחודש.
כ-10 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
פתיחת חשבון לוקחת כמה דקות ולא דורשת כרטיס אשראי. יש שני פרטים קטנים שכדאי להכיר לפני.
פתיחת חשבון בחמישה צעדים
- נכנסים לאתר של Bright Data דרך כרטיס הכלי בפרק הזה, ולוחצים על הרשמה.
- נרשמים, עדיף עם מייל של העסק.
- בלוח הבקרה נכנסים להגדרות החשבון ומעתיקים את מפתח ה-API. הוא מגיע גם במייל הפתיחה.
- שומרים את המפתח במקום בטוח, כמו סיסמה.
- מתחילים מהחינם: 5,000 קרדיטים בכל חודש.
Bright Data
החשבון החינמי נותן 5,000 קרדיטים בכל חודש, בלי כרטיס אשראי, על הסקרייפרים המוכנים, Unlocker, SERP ו-AI Scraper Studio. קישור שותפים של הנרי.
מה כלול בחינם
החינם כולל את הסקרייפרים המוכנים, Unlocker API, SERP API ו-AI Scraper Studio, וגם Browser API בכ-1GB בחודש.
קרדיטים שלא נוצלו לא עוברים לחודש הבא. הפרוקסי, כלומר כתובות IP לשכירה, לא כלולים.
מייל פרטי מול מייל של עסק
נרשמים עם ג'ימייל ובלי אמצעי תשלום? מוצרי הפרוקסי נעולים. כל השאר, כולל הסקרייפרים, פתוח.
מייל של עסק פותח הכל מיד. הוספת כרטיס היא אימות בלבד, וחיוב יש רק כשמפקידים כסף.
כמה זה עולה בפועל
- 1.5$ לכל 1,000 רשומות או בקשות אחרי החינם.
- Browser API עולה 8$ לג'יגה.
- Datasets מוכנים מתחילים ב-2.5$ ל-1,000 רשומות.
- מסלול Scale עולה 499$ לחודש, לעסקים גדולים.
- הנרי אוסף כל יום פוסטים מכמה קבוצות ודפים, ומעריך את העלות ב-3 עד 8 דולר בחודש.
טכניקה מתקדמת: תקרה לפני שמתחילים
קובעים בקוד או בפרומפט מספר מקסימלי של רשומות לכל ריצה. טעות בלולאה בלי תקרה יכולה לשרוף אלפי קרדיטים בדקות.
תרגיל: חשבון של המשימה שלכם
- קחו את השאלה מתרגיל המבוא.
- כמה דפים או רשומות צריך בכל פעם?
- כמה פעמים בחודש?
- הכפילו, והשוו ל-5,000.
איך יודעים שהצליח: יש לכם מספר רשומות חודשי ואתם יודעים אם הוא בתוך החינם.
סקרייפר החזיר 3 פוסטים. כמה קרדיטים זה עלה?
3. בסקרייפרים המוכנים משלמים לפי רשומה, וכל פוסט הוא רשומה.
לתת לקלוד גישה חיה לרשת עם שרת ה-MCP
בסוף הפרק קלוד שלכם יחפש סקרייפר, יריץ אותו ויחזיר לכם טבלה, הכל מתוך הצ'אט.
כ-18 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
MCP הוא חיבור שנותן לקלוד כלים חדשים. אחרי החיבור קלוד יכול לשלוף דף, לחפש בגוגל ולהריץ סקרייפרים של Bright Data בעצמו.
ב-11 באוקטובר 2026 יצאה גרסה 3.0.0 של השרת, ומדריכים ישנים מתארים כלים שכבר לא קיימים.
החיבור הכי פשוט: מחבר מותאם באפליקציה של קלוד
- בקלוד פותחים הגדרות ואז Connectors.
- לוחצים Add custom connector.
- שם: Bright Data.
- כתובת: הכתובת שבקוד למטה, עם המפתח שלכם במקום YOUR_API_TOKEN.
- שומרים, ופותחים שיחה חדשה.
הכתובת, ואיך מוסיפים קבוצות כלים
https://mcp.brightdata.com/mcp?token=YOUR_API_TOKEN

https://mcp.brightdata.com/mcp?token=YOUR_API_TOKEN&groups=scrapers,browser
השורה הראשונה נותנת את הכלים הבסיסיים: חיפוש, שליפת דף ו-discover. השנייה מוסיפה את הסקרייפרים המוכנים ואת הדפדפן.
למי שעובד ב-Claude Code או מתקין מקומית
claude mcp add --transport http brightdata "https://mcp.brightdata.com/mcp?token=YOUR_API_TOKEN"התקנה מקומית בקובץ ההגדרות של Claude Desktop:
{
  "mcpServers": {
    "Bright Data": {
      "command": "npx",
      "args": ["@brightdata/mcp"],
      "env": { "API_TOKEN": "YOUR_API_TOKEN" }
    }
  }
}
ארבע קבוצות הכלים בגרסה 3.0.0
- תמיד פעילים - search_engine, scrape_as_markdown ו-discover.
- scrapers - חיפוש סקרייפר, פרטים, הרצה ותוצאות.
- browser - 14 כלים לדפדפן בענן: ניווט, לחיצה, הקלדה, צילום מסך.
- advanced_scraping - גרסאות אצווה ושליפה כ-HTML.
- geo - מה ChatGPT ו-Perplexity עונים על המותג שלכם: chatgpt_ai_insights ו-perplexity_ai_insights.
אחרי שחיברתם את המחבר עם groups=scrapers, הדביקו בשיחה חדשה בקלוד ומלאו את הסוגריים.
השתמש ב-Bright Data. מצא סקרייפר מוכן ל-[אתר, למשל פוסטים באינסטגרם], הראה לי אילו שדות קלט הוא צריך, ואל תריץ עדיין. אחרי שאאשר, הרץ אותו על [כתובת] עם לכל היותר [מספר] רשומות, והחזר טבלה עם [השדות שחשובים לי].
קלוד מציג את הסקרייפר ושדות הקלט, מחכה לאישור שלכם, ואחרי ההרצה מחזיר טבלה מסודרת.
המפתח הוא סיסמה
מי שמחזיק בכתובת עם ה-token יכול לבזבז לכם קרדיטים. אל תשתפו צילום מסך של ההגדרות ואל תדביקו אותה בצ'אט ציבורי.
למי שהלקוח שלו תומך בזה, יש גם התחברות OAuth בלי token בכתובת.
טכניקה מתקדמת: מגן מפני הוראות זדוניות
מגרסה 2.12.0, אם דף שנשלף נראה כמו הוראה לשנות את הגדרות השרת, השרת שואל אתכם לפני שהוא ממשיך. זה לא מכסה את כלי הדפדפן, ולכן בדפדפן כדאי לעבוד רק עם אתרים שאתם מכירים.
בדיקה ראשונה: קריאה אחת פשוטה
אחרי החיבור בקשו מקלוד דבר אחד קטן ובדקו שחזרה תשובה. בבדיקה שלנו ב-12 באוקטובר 2026 הסקרייפרים עבדו, אבל החיפוש והשליפה החזירו תוצאה ריקה. אם זה קורה לכם, בדקו בלוח הבקרה ופנו לתמיכה.
לפני הסרטון
הסרטון מהערוץ מסביר מה זה MCP ואיך מחברים שרת לקלוד באופן כללי. ההגדרות של Bright Data עצמן נמצאות למעלה.
🎬 איך לחבר את קלוד לכל האינטרנט? מדריך מהיר ל-MCP
תרגיל: חברו ובדקו
- חברו את Bright Data כמחבר בקלוד.
- בקשו: ״מצא סקרייפר מוכן לביקורות בגוגל מפות, ואל תריץ״.
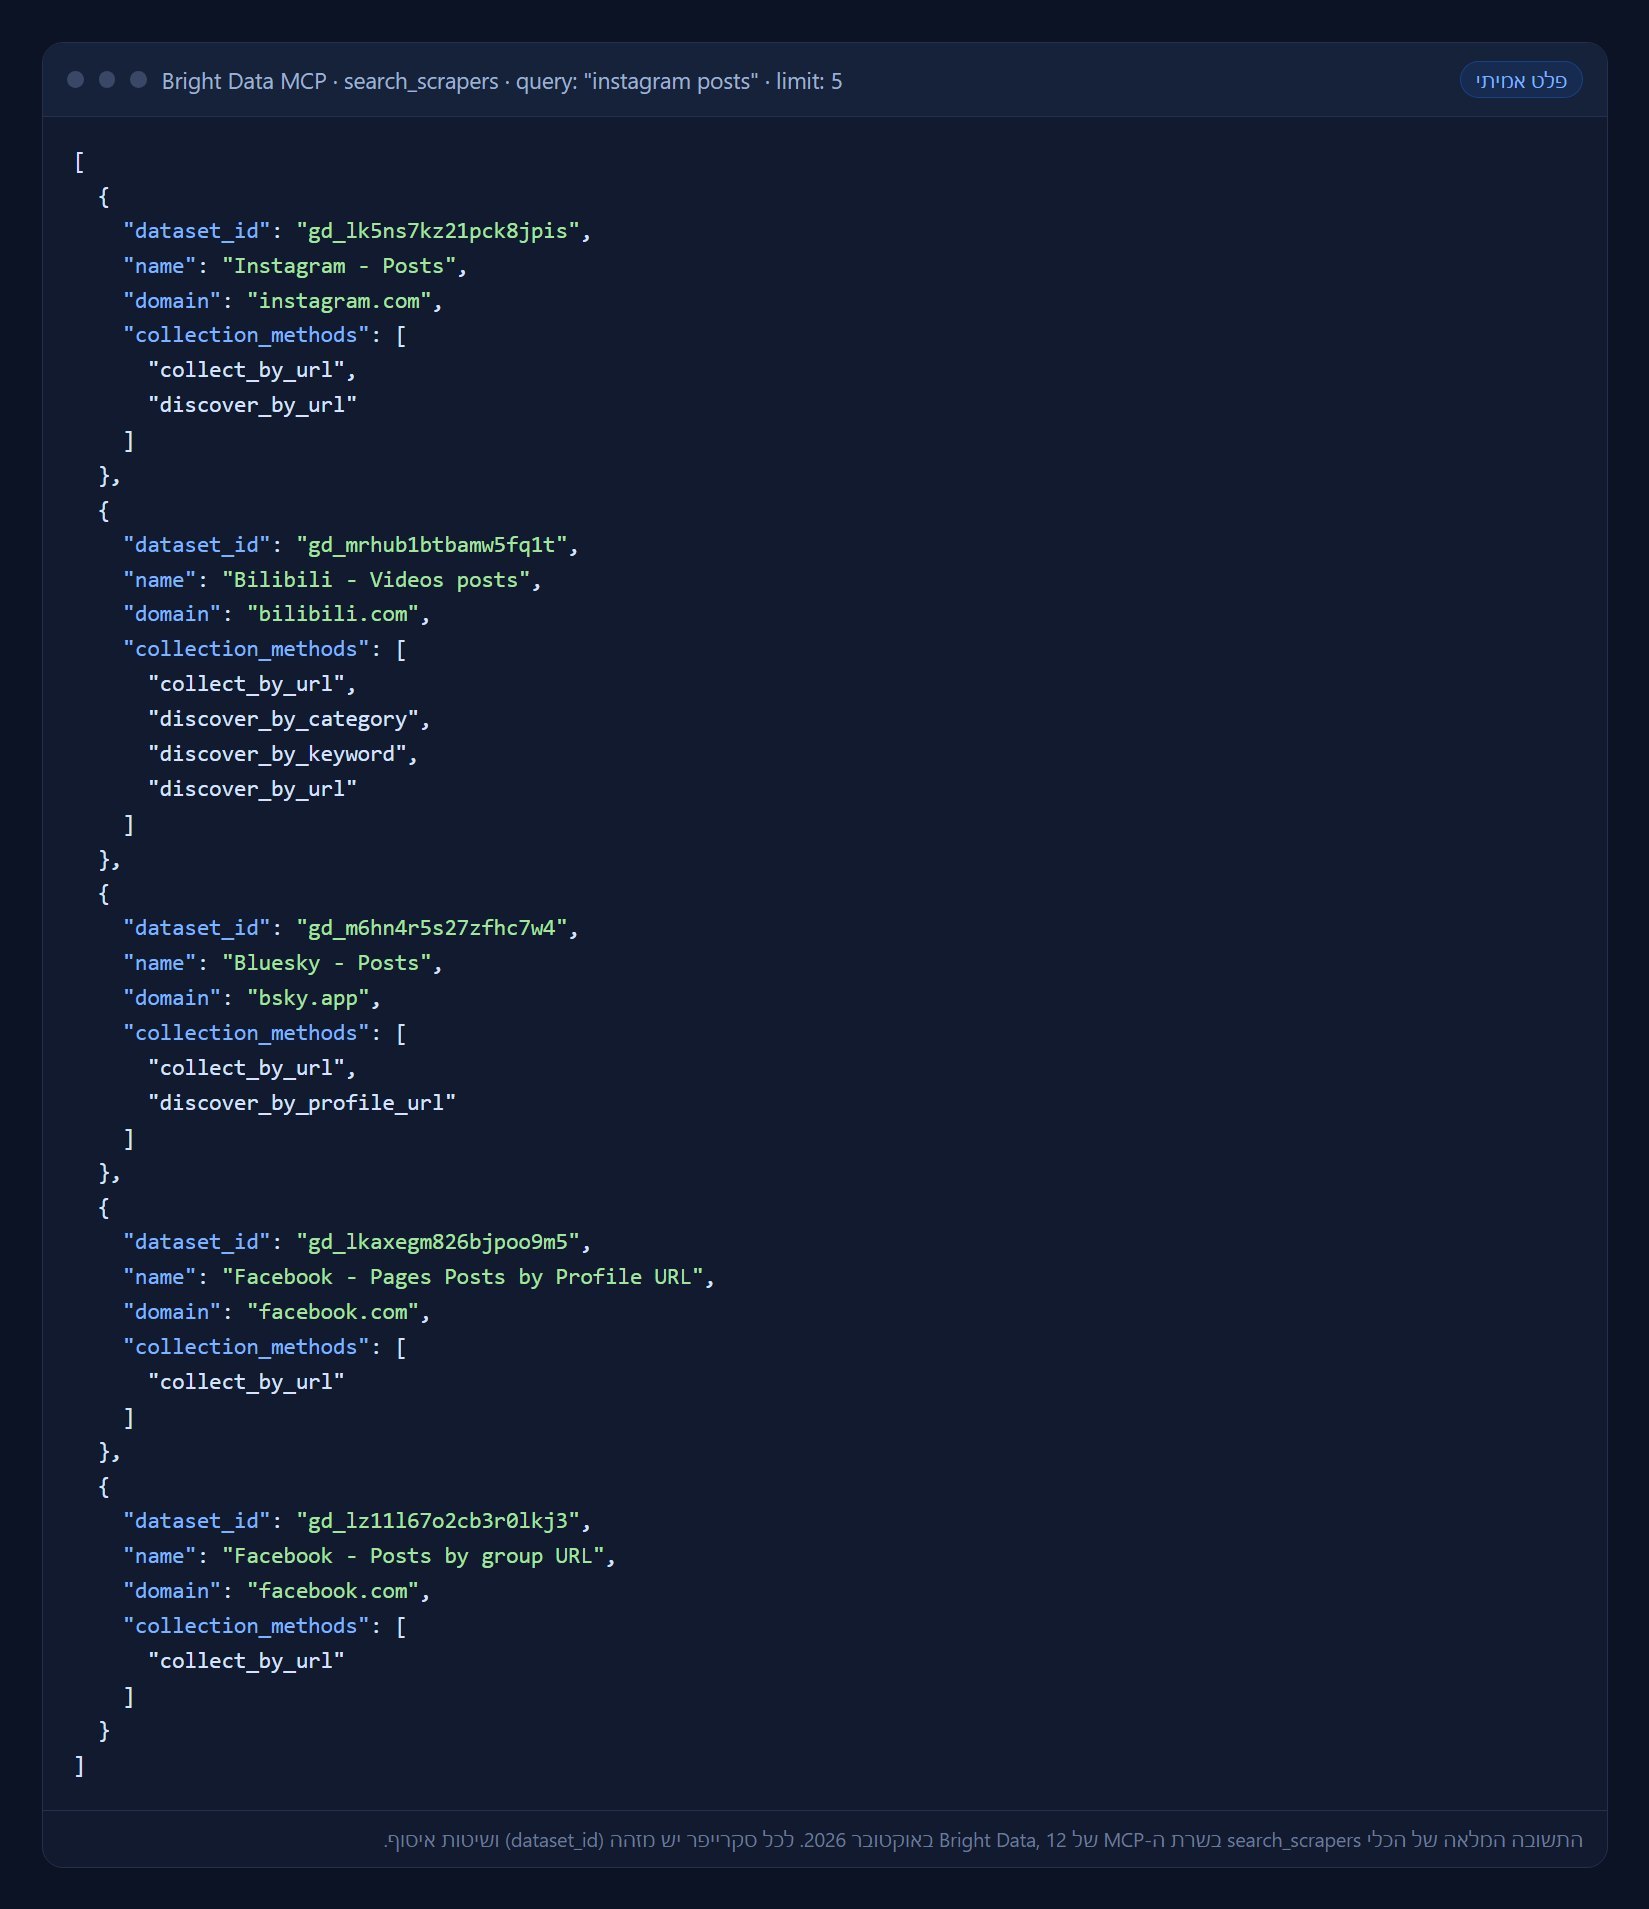
- ודאו שחזר שם של סקרייפר ומזהה שמתחיל ב-gd_.
איך יודעים שהצליח: קלוד החזיר סקרייפר אמיתי עם dataset_id, בלי להריץ ובלי לבזבז קרדיטים.
למה כדאי לבקש מקלוד ״אל תריץ עדיין״ בפעם הראשונה?
כי חיפוש סקרייפר והצגת פרטים כמעט לא עולים, והרצה עולה לפי רשומה. רואים קודם מה ירוץ ועל כמה רשומות, ורק אז מאשרים.
מעקב מחירים של מתחרים
בסוף הפרק תריצו בדיקת מחירים על מוצר, ותדעו להפוך אותה למעקב קבוע.
כ-15 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
המתחרה הוריד מחיר, ואתם שומעים על זה מלקוח. מעקב מחירים הופך את זה לטבלה שמגיעה אליכם.
יש שתי דרכים: סקרייפר מוכן לאתרים גדולים כמו אמזון, ושליפת דף לכל אתר אחר.
שתי הדרכים
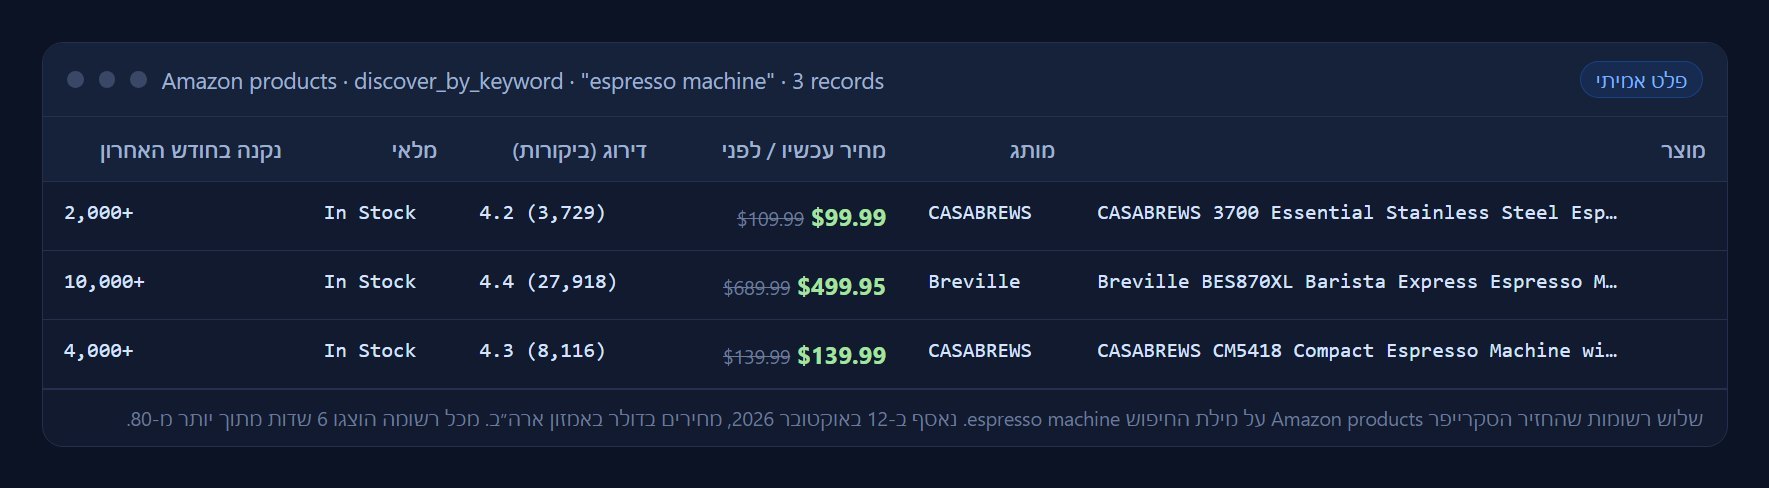
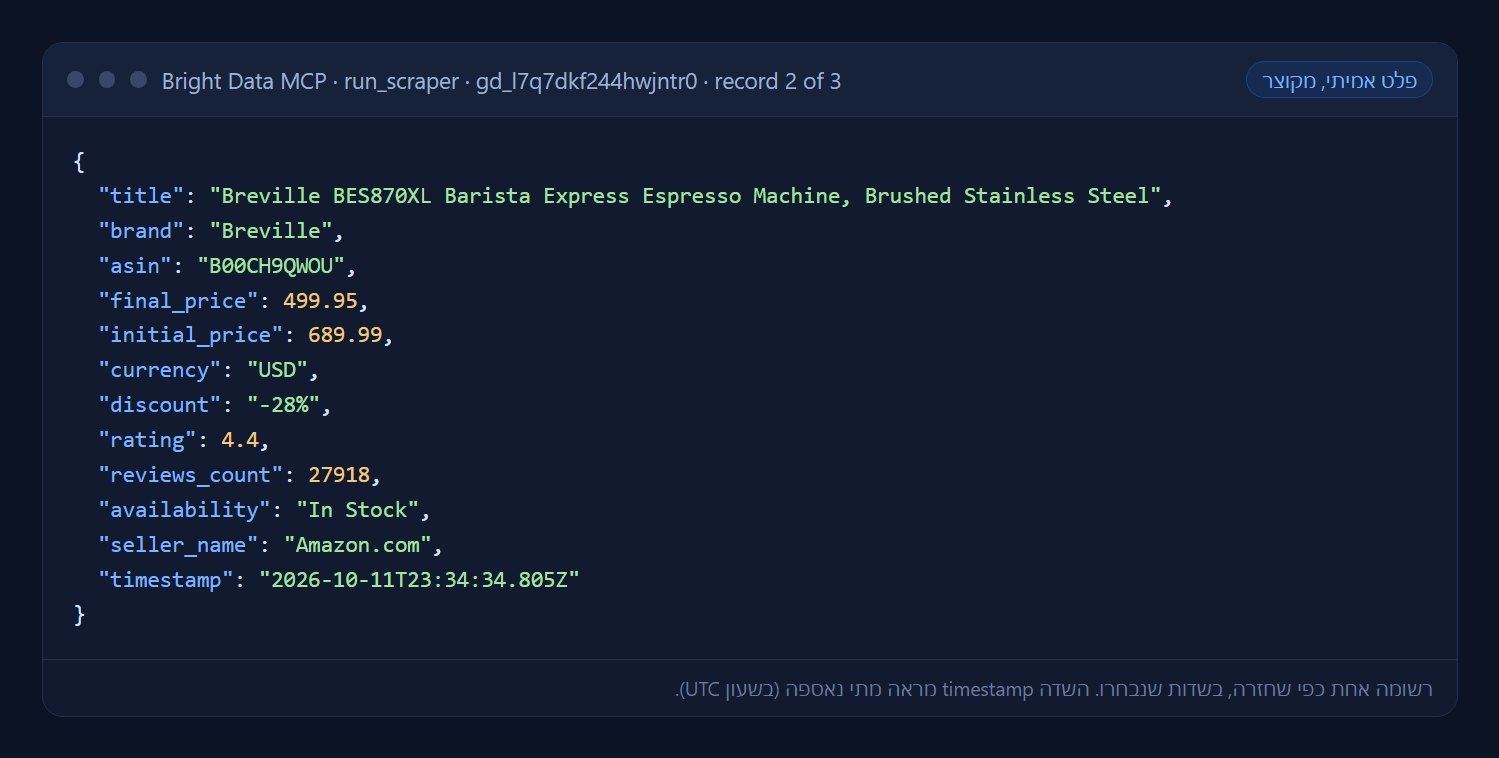
- אתר גדול עם סקרייפר מוכן (אמזון, וולמארט ועוד): הסקרייפר Amazon products מחזיר מחיר עכשיו, מחיר קודם, דירוג, מלאי ועוד יותר מ-80 שדות.
- כל אתר אחר, כולל חנויות ישראליות: שולפים את דף המחירון כטקסט עם Unlocker או עם scrape_as_markdown, ומבקשים מקלוד לחלץ את המחירים.
בקלוד עם מחבר Bright Data וקבוצת scrapers. התחילו מ-3 רשומות.
השתמש ב-Bright Data. הרץ את הסקרייפר Amazon products בשיטת discover_by_keyword על [מילת חיפוש באנגלית], עם לכל היותר [3] רשומות. החזר טבלה: שם המוצר, מותג, מחיר עכשיו, מחיר לפני, דירוג, מספר ביקורות ומלאי.
טבלה עם שלושה מוצרים ומחירים בדולר, ושדה זמן איסוף לכל שורה.
טכניקה מתקדמת: מעקב ולא תמונת מצב
ריצה אחת היא תמונת מצב. שומרים כל ריצה עם שדה הזמן לגיליון, ומשווים שבוע מול שבוע. קלוד יכול לסכם רק את מה שזז: מחיר שירד, מוצר שאזל, מבצע חדש.
מה לא לעשות
אל תשאבו אתר קטן אלפי פעמים ביום. מתחרה ישראלי קטן לא צריך יותר מבדיקה אחת ביום, וזה גם זול יותר לכם.
תרגיל: שלושה מתחרים
- בחרו מוצר אחד שלכם ושלושה מתחרים.
- אם הם באמזון, הריצו את הסקרייפר. אם לא, בקשו מקלוד לשלוף את דף המוצר של כל אחד.
- בקשו טבלה אחת עם המחיר שלכם מול שלהם.
איך יודעים שהצליח: יש לכם טבלה אחת עם ארבעה מחירים ותאריך בדיקה.
החנות של המתחרה ישראלית ואין לה סקרייפר מוכן. מה עושים?
שולפים את הדף עצמו עם Unlocker או scrape_as_markdown ומבקשים מקלוד לחלץ את המחיר. סקרייפר מוכן קיים רק לאתרים גדולים.
נתונים מרשתות חברתיות: אינסטגרם ופייסבוק
בסוף הפרק תדעו אילו סקרייפרים יש לרשתות החברתיות, מה הם מחזירים, ואיפה הגבול.
כ-12 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
הנרי השתמש ב-11 באוקטובר 2026 בשלושה סקרייפרים: פוסטים מאינסטגרם, פוסטים מדפי פייסבוק ופוסטים מקבוצות פייסבוק ציבוריות.
המטרה הייתה לאסוף כל יום אירועים שמתפרסמים בקבוצות ובדפים של עיר מסוימת, ולהפוך אותם ללוח אירועים.
שלושת הסקרייפרים, בשמות המדויקים
- Instagram - Posts - פוסטים מפרופיל, לפי כתובת הפרופיל.
- Facebook - Pages Posts by Profile URL - פוסטים מדף עסקי.
- Facebook - Posts by group URL - פוסטים מקבוצה ציבורית.
כדאי לחפש בשם המדויק. בחיפוש ״Facebook group posts״ קל להתבלבל.
מה חוזר מכל פוסט
- כתובת הפוסט ותאריך הפרסום.
- הטקסט המלא והאשטגים.
- סוג: תמונה, רילס או קרוסלה, ואורך הסרטון.
- קישורים לתמונות ולסרטונים.
- פרטי הפרופיל: עוקבים ומספר פוסטים.
טכניקה מתקדמת: רק מה שחדש
בסקרייפר של אינסטגרם יש שדות start_date ו-end_date. בפורמט חודש-יום-שנה, למשל 10-11-2026. הנרי שומר את מועד הריצה האחרונה ומבקש רק פוסטים מאז. ככה משלמים רק על חדש.
המספרים שחזרו אפס
בהרצה שלנו לייקים ותגובות חזרו 0 לפוסטים שהיו בני כמה שעות. התייחסו למספרי מעורבות כתמונת מצב של רגע האיסוף, ובדקו מול האפליקציה לפני שמסיקים מסקנות.
קבוצות פרטיות ואנשים פרטיים
קבוצה פרטית לא מחזירה פוסטים, וזה בסדר. ופוסטים של אנשים פרטיים הם מידע אישי: אספו רק מה שאתם צריכים, אל תבנו פרופילים של אנשים, ואל תפרסמו את מה שאספתם.
תרגיל: הפרופיל שלכם
- בקשו מקלוד להריץ את Instagram - Posts על הפרופיל העסקי שלכם, עם 5 פוסטים.
- בקשו טבלה: תאריך, סוג, תחילת הטקסט, האשטגים.
- מה פרסמתם הכי הרבה החודש?
איך יודעים שהצליח: יש לכם טבלה של 5 פוסטים שלכם, בעלות של 5 קרדיטים.
למה עדיף לבקש פוסטים מתאריך מסוים ולא ״כל הפוסטים״?
כי משלמים לפי רשומה. פרופיל עם מאות פוסטים יעלה מאות קרדיטים, וברוב המקרים צריך רק את מה שחדש מאז הבדיקה הקודמת.
רשימות לידים: עסקים מגוגל מפות וחברות מלינקדאין
בסוף הפרק תדעו לבנות רשימת עסקים מתחום ואזור מסוים, ומה מותר לעשות איתה.
כ-10 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
רשימת לידים טובה היא רשימה קצרה ומדויקת: עסקים בתחום שלכם, באזור שלכם, עם פרטים ציבוריים. Bright Data עוזרת לאסוף, אבל השימוש באחריותכם.
מאיפה מגיעים לידים
- גוגל מפות - עסקים לפי תחום ואזור, עם דירוג וביקורות. בספרייה יש סקרייפר Google maps reviews ועוד.
- לינקדאין - מידע על חברות: תחום, גודל, אתר. הסקרייפר נקרא LinkedIn company information.
- חיפוש - SERP API מחזיר את מי שמופיע בגוגל על ״רואה חשבון בחיפה״.
תהליך עבודה מומלץ
- מגדירים פרופיל לקוח: תחום, אזור, גודל.
- מבקשים מקלוד לחפש את הסקרייפר המתאים ולהציג שדות.
- מריצים על 10 רשומות בלבד ובודקים איכות.
- מנקים כפילויות ועסקים שנסגרו.
- רק אז מגדילים.
החוק בישראל
שליחת הודעות שיווקיות במייל, ב-SMS או בוואטסאפ בלי הסכמה מראש מוגבלת בחוק התקשורת, בסעיף שמוכר כ״חוק הספאם״. גם חוק הגנת הפרטיות חל על מידע על אנשים.
רשימה מהרשת היא נקודת פתיחה למחקר ולפנייה אישית, לא לדיוור המוני. בספק, התייעצו עם עורך דין.
טכניקה מתקדמת: ביקורות במקום טלפונים
בגוגל מפות, הביקורות שימושיות יותר מהטלפון. עסק שהלקוחות שלו מתלוננים על זמני תגובה הוא ליד חם לבוט שירות. בקשו מקלוד לסכם תלונות חוזרות.
תרגיל: עשרה עסקים
- בחרו תחום ועיר.
- בקשו מקלוד למצוא סקרייפר לגוגל מפות ולהציג את שדות הקלט.
- הריצו על 10 רשומות.
- סמנו כמה מהם באמת רלוונטיים.
איך יודעים שהצליח: יש לכם רשימה של 10 עסקים ואחוז רלוונטיות. מתחת ל-50% צריך לדייק את החיפוש.
אספתם 500 עסקים עם מספרי טלפון. מותר לשלוח לכולם הודעת וואטסאפ שיווקית?
לא בלי הסכמה מראש. חוק הספאם מגביל הודעות שיווקיות בלי הסכמה. משתמשים ברשימה למחקר ולפנייה אישית ומדויקת.
למפתחים: ה-API, הקוד, ומה קורה מאחורי הקלעים
בסוף הפרק תוכלו להריץ סקרייפר של Bright Data מקוד, בשלושה שלבים, בלי MCP.
כ-12 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
שרת ה-MCP נוח לעבודה מהצ'אט. כשצריך ריצה קבועה כל יום, עדיף קוד שרץ לבד. הקוד בפרק מבוסס על מה שהנרי מריץ בפועל.
שלושה שלבים: הפעלה, המתנה, הורדה
- trigger - שולחים רשימת קלטים ומקבלים snapshot_id.
- progress - בודקים כל כמה שניות עד שהסטטוס ready.
- snapshot - מורידים את הרשומות כ-JSON.
זה אסינכרוני: ריצה יכולה לקחת שניות או דקות.
הקוד בפייתון
import json, time, urllib.request

BASE = "https://api.brightdata.com/datasets/v3"
HDR = {"Authorization": "Bearer YOUR_API_TOKEN",
       "Content-Type": "application/json"}

def call(method, url, body=None):
    data = json.dumps(body).encode() if body is not None else None
    req = urllib.request.Request(url, data=data, headers=HDR, method=method)
    with urllib.request.urlopen(req, timeout=120) as r:
        return json.loads(r.read())

# Instagram - Posts, discover by profile URL
q = "dataset_id=gd_lk5ns7kz21pck8jpis&include_errors=true&type=discover_new&discover_by=url"
sid = call("POST", f"{BASE}/trigger?{q}",
           [{"url": "https://www.instagram.com/YOUR_PROFILE/", "num_of_posts": 5}])["snapshot_id"]

while call("GET", f"{BASE}/progress/{sid}").get("status") != "ready":
    time.sleep(10)

posts = call("GET", f"{BASE}/snapshot/{sid}?format=json")
print(len(posts), "records")
מזהי ה-dataset שבשימוש אצל הנרי
- Instagram - Posts: gd_lk5ns7kz21pck8jpis
- Facebook - Pages Posts by Profile URL: gd_lkaxegm826bjpoo9m5
- Facebook - Posts by group URL: gd_lz11l67o2cb3r0lkj3
לכל סקרייפר אחר: search_scrapers ב-MCP או הספרייה באתר.
טכניקה מתקדמת: שלוש הגנות בקוד
- תקרת זמן להמתנה, כדי שריצה תקועה לא תחסום.
- include_errors=true, וסינון רשומות עם שדה error.
- תקרת רשומות לכל מקור. בפייסבוק ובאינסטגרם, אם Bright Data נכשל, הקוד של הנרי עובר לגיבוי ב-Apify.
אל תשמרו את המפתח בקוד
בדוגמה המפתח כתוב בקוד רק לשם ההסבר. בפועל שומרים אותו במשתנה סביבה או בסוד של GitHub Actions.
AI Scraper Studio ו-Browser API
אין סקרייפר מוכן לאתר שלכם? ב-AI Scraper Studio מתארים במילים מה לאסוף, והוא בונה סקרייפר שרץ באותו API. צריך ללחוץ ולמלא טפסים? Browser API עובד עם Puppeteer, Playwright ו-Selenium.
מדריך עומק: הרצת סקרייפר מוכן מתוך קלוד, מקצה לקצה
בסוף הפרק תעברו את כל המסלול: חיפוש סקרייפר, בדיקת שדות, הרצה, וטבלה מוכנה.
כ-20 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
כל הצילומים בפרק הם פלט אמיתי של שרת ה-MCP של Bright Data מ-12 באוקטובר 2026. הרצנו את Instagram - Posts על החשבון של הנרי, ai.henry.ai, עם 3 פוסטים.
ארבעה צעדים
- search_scrapers - ״instagram posts״. חוזרים סקרייפרים עם מזהה ושיטות איסוף.
- get_scraper_details - בוחרים שיטה, למשל discover_by_url, ורואים אילו שדות קלט היא צריכה.
- run_scraper - מריצים עם כתובת וכמות. אם זה לוקח יותר מ-45 שניות, חוזר מזהה ובודקים אחר כך.
- get_scraper_results - מקבלים את הרשומות, וקלוד הופך אותן לטבלה.
בקלוד עם מחבר Bright Data וקבוצת scrapers. החליפו את הסוגריים בפרופיל שלכם.
השתמש ב-Bright Data. 1) חפש סקרייפר לפוסטים באינסטגרם. 2) הצג את שדות הקלט של השיטה discover_by_url. 3) הרץ על https://www.instagram.com/[הפרופיל העסקי שלי]/ עם num_of_posts 3. 4) החזר טבלה: תאריך, סוג פוסט, 60 התווים הראשונים של הטקסט, האשטגים. 5) כתוב כמה רשומות חויבו.
שלושה פוסטים בטבלה, ושורה שאומרת שחויבו 3 רשומות.
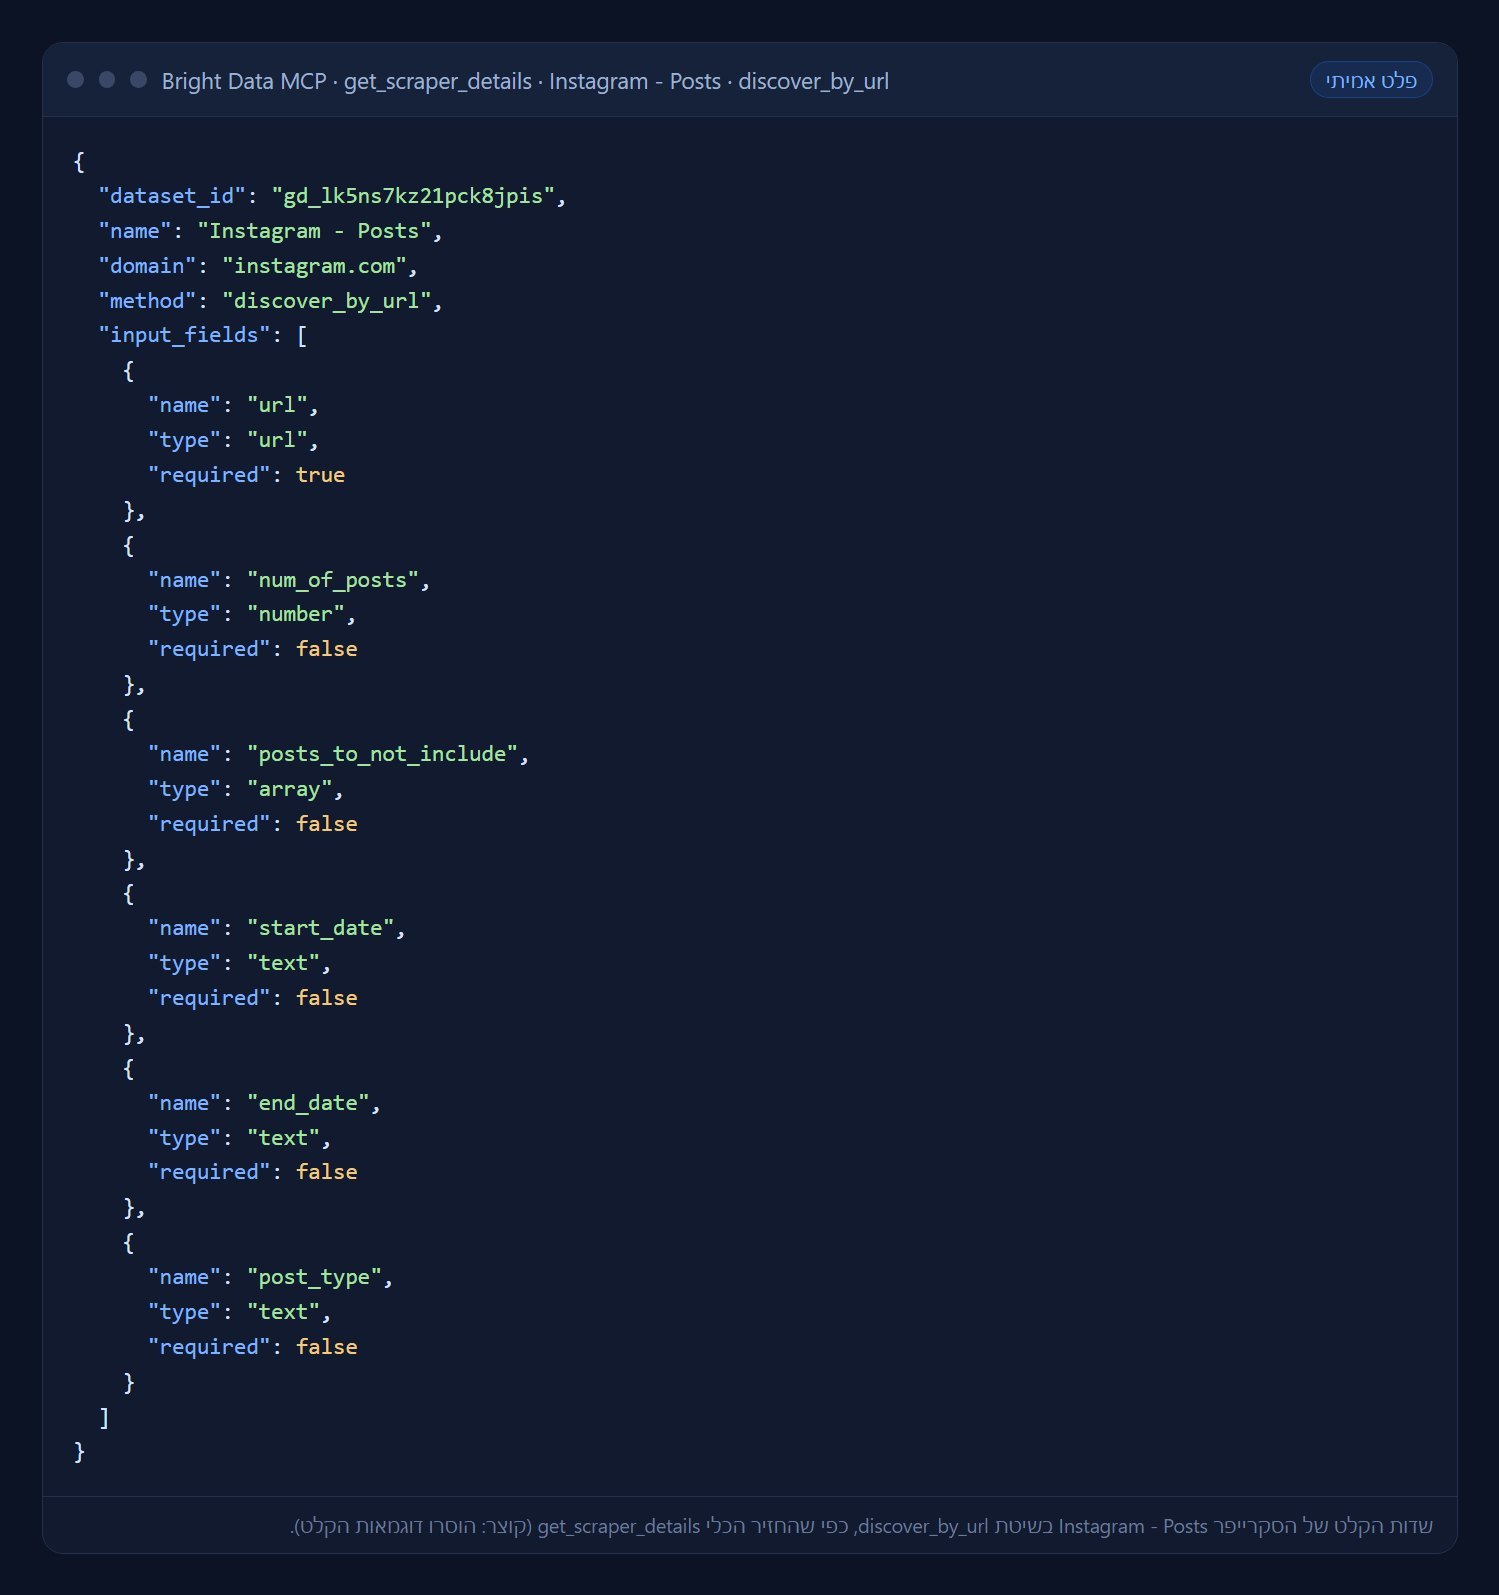
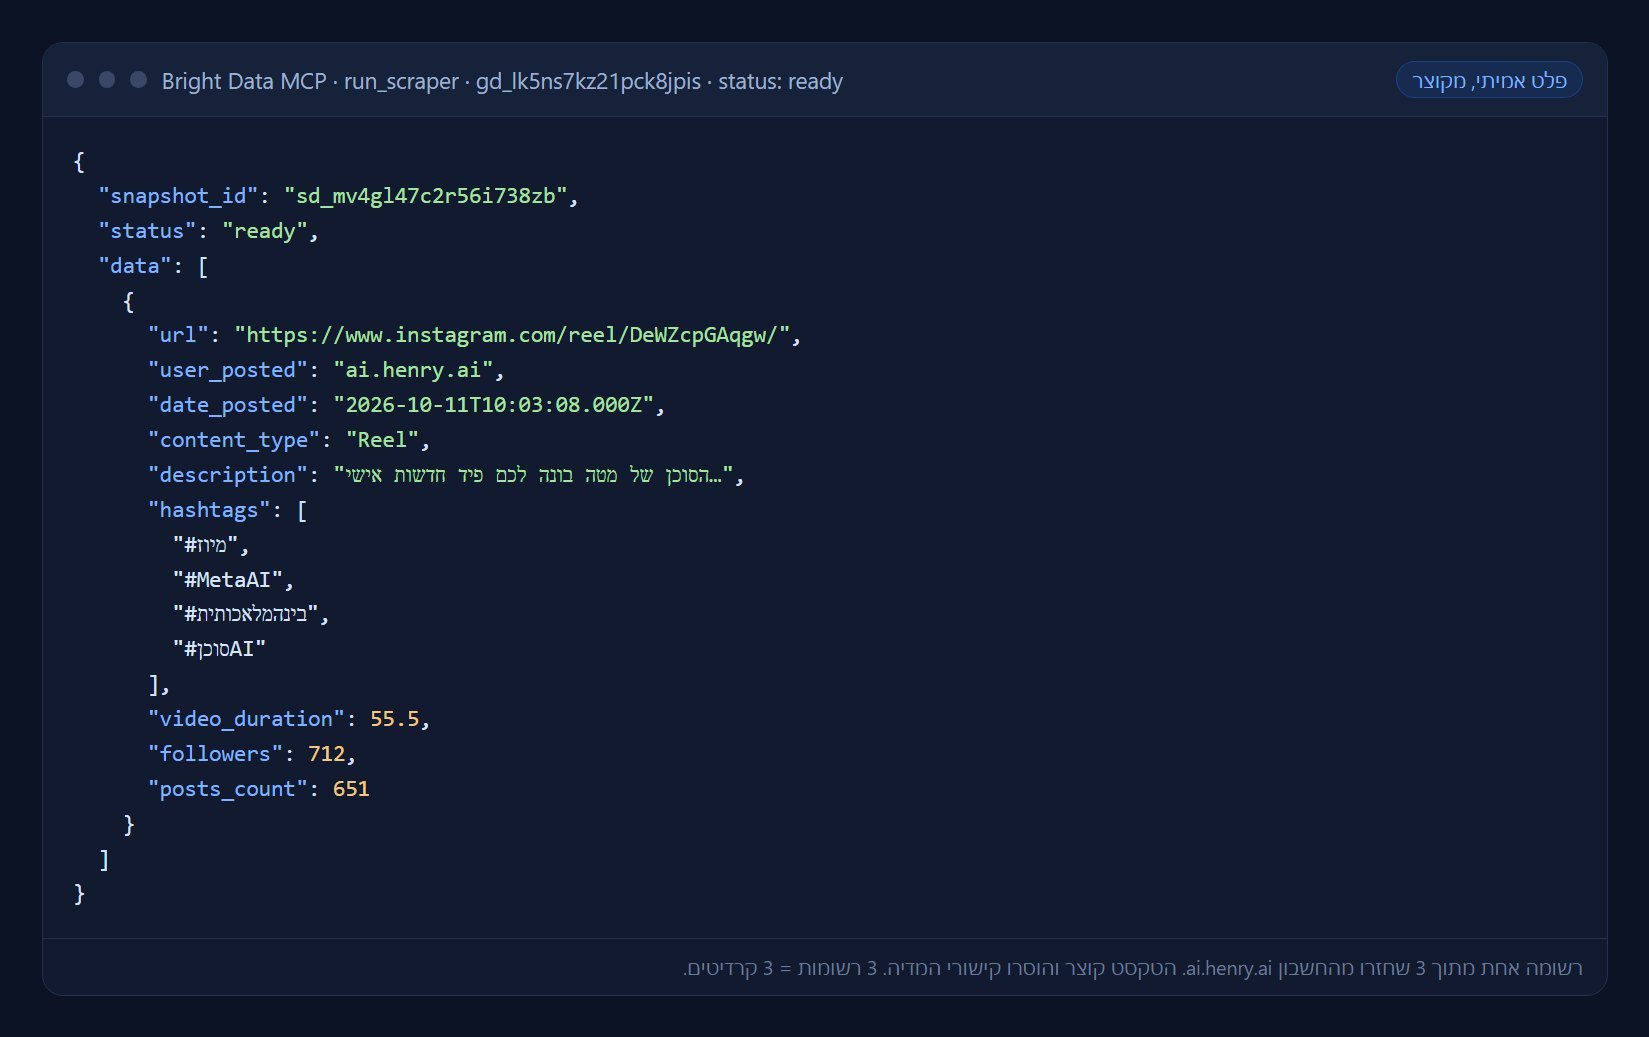
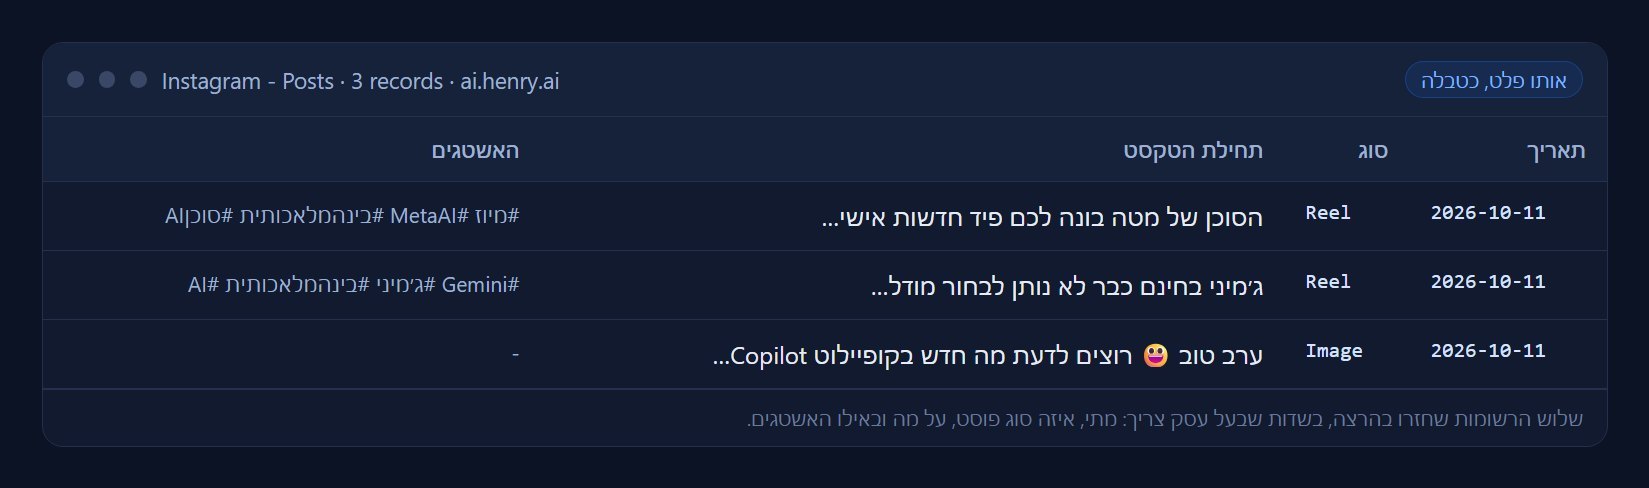
מה ראינו בהרצה האמיתית
- התוצאה חזרה מוכנה בתוך ההמתנה, בלי צורך לבדוק שוב.
- כל רשומה הכילה עשרות שדות, כולל קישורים לסרטונים ולתמונות.
- לייקים ותגובות חזרו 0, כנראה כי הפוסטים היו בני שעות.
טכניקה מתקדמת: שמרו את ה-snapshot_id
המזהה מאפשר להוריד שוב את אותה תוצאה בלי להריץ מחדש. שמרו אותו עם התאריך, במיוחד בריצות גדולות.
תרגיל: אותו מסלול על פייסבוק
- בקשו מקלוד את הסקרייפר Facebook - Pages Posts by Profile URL.
- הציגו את שדות הקלט.
- הריצו על הדף העסקי שלכם עם 3 פוסטים.
- השוו לטבלה של אינסטגרם.
איך יודעים שהצליח: יש לכם שתי טבלאות, ואתם יודעים איזה סקרייפר מחזיר אילו שדות.
run_scraper החזיר status running במקום נתונים. האם הריצה נכשלה?
לא. ההמתנה היא עד 45 שניות. ממשיכים עם get_scraper_progress, ואחרי שהסטטוס ready מבקשים get_scraper_results עם אותו snapshot_id.
חוקי או לא? חוקיות ואתיקה של איסוף מידע
בסוף הפרק תדעו להבחין בין איסוף לגיטימי לבין שימוש בעייתי, ומה המשפט בארה״ב אמר.
כ-8 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
השאלה הראשונה שאנשים שואלים היא ״זה בכלל חוקי?״. התשובה הקצרה: איסוף מידע ציבורי הוא תחום שבתי משפט בארה״ב עסקו בו, והשימוש במידע הוא מה שקובע.
מה קרה בבתי המשפט
- Meta תבעה את Bright Data, הפסידה בטענה החוזית בינואר 2024 ומשכה את התביעה בפברואר 2024.
- X (טוויטר) תבעה גם היא. התביעה נדחתה במאי 2024, ובנובמבר 2024 הותר ל-X להגיש תביעה מתוקנת, וחלק ממנה ממשיך. לא מצאנו הכרעה סופית.
הקווים הברורים
- מידע ציבורי, בלי התחברות: זה התחום שבו עוסקים הפסקים.
- מידע מאחורי סיסמה או בקבוצה פרטית: לא.
- מידע על אנשים פרטיים: מינימום הכרחי, וחוקי הפרטיות חלים.
- עומס על אתר קטן: לא אוספים יותר מהצורך.
זה משפט אמריקאי, ואתם בישראל
הפסקים האלה הם של בתי משפט בארה״ב. בישראל חל חוק הגנת הפרטיות, וגם תנאי השימוש של האתרים עצמם.
הדף הזה לא ייעוץ משפטי. לפני פרויקט שאוסף מידע על אנשים, התייעצו עם עורך דין.
מה Bright Data עצמה אוסרת
במדיניות הציות והאתיקה שלה Bright Data אוסרת הונאה וגישה לא מורשית, ויש לה צוות שבודק שימושים. זה לא מחליף את האחריות שלכם על מה שאתם עושים עם הנתונים.
תרגיל: בדיקת שלוש שאלות
על כל משימת איסוף שלכם ענו: 1. האם המידע ציבורי בלי התחברות? 2. האם יש בו מידע על אנשים פרטיים? 3. מה תעשו איתו?
איך יודעים שהצליח: יש לכם תשובה לשלוש השאלות לכל משימה, ואתם יודעים איזו משימה צריכה בדיקה משפטית.
Bright Data ניצחה את Meta בבית משפט. האם זה אומר שמותר לאסוף הכל מאינסטגרם?
לא. ההליכים עסקו במידע ציבורי בארה״ב, ו-X עדיין ממשיכה בחלק מהתביעה. מידע פרטי, תנאי שימוש וחוקי פרטיות בישראל עדיין חלים.
תרגול: פרויקט קטן מקצה לקצה
בסוף הפרק יהיה לכם תהליך אחד שעובד, על נתונים אמיתיים מהתחום שלכם.
כ-30 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
חוזרים לשאלה מתרגיל המבוא ובונים לה תהליך שלם, בתוך 5,000 הקרדיטים החינמיים.
הפרויקט בשישה צעדים
- מנסחים שאלה עסקית אחת.
- בוחרים מוצר: סקרייפר מוכן, שליפת דף או חיפוש.
- מריצים על 3 עד 10 רשומות ובודקים איכות.
- מבקשים מקלוד טבלה וסיכום של שלוש תובנות.
- מחשבים עלות חודשית.
- מחליטים: ריצה ידנית פעם בשבוע, או קוד שרץ לבד.
שלושה רעיונות לפרויקט
- מחירי שלושה מתחרים, פעם בשבוע.
- סיכום חודשי של הפוסטים שלכם ושל שני מתחרים באינסטגרם.
- מה ChatGPT עונה כששואלים עליכם, עם הכלי chatgpt_ai_insights.
להפוך את זה לקבוע
ריצה שבועית ידנית בקלוד מספיקה לרוב העסקים. למי שרוצה אוטומציה מלאה, יש קורס על משימות מתוזמנות עם AI.
הפרויקט
בצעו את ששת הצעדים. שמרו את הפרומפט שעבד, כדי להריץ אותו שוב בשבוע הבא.
איך יודעים שהצליח: יש לכם טבלה, שלוש תובנות, עלות חודשית ופרומפט שמור.
סיכום וצעדים הבאים
בסוף הפרק תדעו מה לעשות מחר בבוקר.
כ-4 דקות עם התרגול · נבדק לאחרונה: 12.10.2026
Bright Data נותנת לעסק קטן גישה לנתונים מהרשת שפעם היו רק לחברות גדולות. ההבדל בין שימוש טוב לבזבוז הוא שאלה ברורה ותקרה על הכמות.
מה לוקחים מהקורס
- מתחילים בחינם: 5,000 קרדיטים בחודש, בלי כרטיס.
- קודם מחפשים סקרייפר מוכן, ורק אם אין שולפים דף.
- מחברים את קלוד דרך MCP ומבקשים ״אל תריץ עדיין״ בפעם הראשונה.
- תמיד שמים תקרה על כמות הרשומות.
- אוספים רק מידע ציבורי, ושומרים על פרטיות של אנשים.
לפתיחת חשבון
הכפתור בכרטיס למטה הוא קישור שותפים: הנרי מקבל אחוז מתשלומים, והמחיר שלכם לא משתנה.
Bright Data
5,000 קרדיטים חינם בכל חודש בלי כרטיס אשראי, יותר מ-1,000 סקרייפרים מוכנים ושרת MCP לקלוד. מתחילים מסקרייפר אחד ותקרה של כמה רשומות.
שאלות נפוצות
האם Bright Data חינמי?
יש מסלול חינמי קבוע: כל חשבון חדש מקבל 5,000 קרדיטים בכל חודש, בשווי של כ-7.5$, בלי כרטיס אשראי. קרדיט אחד הוא בקשה אחת או רשומה אחת. קרדיטים שלא נוצלו לא עוברים לחודש הבא. אחרי החינם המחיר הוא 1.5$ לכל 1,000 רשומות או בקשות, נכון ל-12 באוקטובר 2026.
איך מחברים את Bright Data לקלוד?
דרך שרת ה-MCP הרשמי. בקלוד פותחים הגדרות, Connectors, מוסיפים מחבר מותאם ומדביקים את הכתובת mcp.brightdata.com/mcp עם מפתח ה-API שלכם. כדי לקבל גם את הסקרייפרים המוכנים מוסיפים לכתובת groups=scrapers. השרת נותן 5,000 בקשות חינם בחודש, ומגרסה 3.0.0 יש בו 32 כלים.
האם איסוף מידע עם Bright Data חוקי?
בארה״ב Meta משכה תביעה נגד Bright Data ב-2024, ותביעה של X נדחתה במאי 2024 וחלק ממנה חודש בנובמבר. ההליכים עסקו במידע ציבורי בלי התחברות. בישראל חל חוק הגנת הפרטיות, ושליחת הודעות שיווקיות בלי הסכמה מוגבלת. אספו מידע ציבורי בלבד, ובספק התייעצו עם עורך דין.
מה ההבדל בין Bright Data ל-Apify?
בשתיהן יש סקרייפרים מוכנים לרשתות חברתיות ושרת MCP. ב-Bright Data הסקרייפרים שלה והטיפול בחסימות בפנים, ומשלמים 1.5$ ל-1,000 רשומות אחרי 5,000 קרדיטים חינם. Apify היא חנות של עשרות אלפי כלים שבנו מפתחים, עם 5$ שימוש חינם בחודש ומנוי Starter ב-19$.
אפשר להשתמש ב-Bright Data בלי לדעת לתכנת?
כן. מחברים אותה לקלוד דרך MCP ומבקשים בעברית, למשל ״מצא סקרייפר לפוסטים באינסטגרם והרץ על הפרופיל שלי עם 3 פוסטים״. קלוד מוצא את הסקרייפר, מריץ ומחזיר טבלה. קוד צריך רק כשרוצים ריצה קבועה שרצה לבד כל יום.
סרטונים קשורים
כלים בקורס
מקורות
- Bright Data - Free tier · Bright Data Docs, 2026-10-12
- Bright Data - Payment verification · Bright Data Docs, 2026-10-12
- Web Scraper API - pricing · Bright Data, 2026-10-12
- Unlocker API - pricing · Bright Data, 2026-10-12
- SERP API · Bright Data, 2026-10-12
- Browser API - pricing · Bright Data, 2026-10-12
- Datasets - pricing · Bright Data, 2026-10-12
- Web Scraper API - product page · Bright Data, 2026-10-12
- About Bright Data · Bright Data, 2026-10-12
- Bright Data MCP server · Bright Data, 2026-10-12
- brightdata-mcp - README and CHANGELOG (v3.0.0) · GitHub, 2026-10-12
- MCP remote quickstart · Bright Data Docs, 2026-10-12
- Compliance & Ethics policies · Bright Data, 2026-10-12
- Elon Musk's X loses lawsuit against Bright Data over data scraping · CNBC, 2026-10-12
- Meta drops lawsuit against web-scraping firm Bright Data · TechCrunch, 2026-10-12
- Apify pricing · Apify, 2026-10-12
- Firecrawl pricing · Firecrawl, 2026-10-12
- ScrapeGraphAI pricing · ScrapeGraphAI, 2026-10-12